1시간 오디오를 13초 만에 받아쓰는 맥북 에어 전용 무료 STT 모델 등장
핵심 요약
- 구글 EmbeddingGemma 2 임베딩 모델을 활용해 오디오 조각을 텍스트 공간에 직접 매핑하는 방식으로 음성 인식 모델을 구축했습니다.
- 기본형 M3 맥북 에어의 뉴럴 엔진에서 1시간짜리 오디오를 단 12.6초 만에 온디바이스로 처리합니다.
- 현재 단어 오류율은 약 5% 수준이며, 외부 데이터 전송 없이 로컬에서 바로 받아쓰기를 지원하는 무료 Mac 앱으로 배포되었습니다.
요약 구글의 멀티모달 임베딩 모델인 'EmbeddingGemma 2'를 음성 인식(STT) 모델로 탈바꿈시킨 프로젝트가 공개되어 화제를 모으고 있습니다. 본래 텍스트, 이미지, 오디오, 비디오를 하나의 공유 임베딩 공간에 매핑하는 이 모델의 특성을 활용해, 음성 오디오 조각이 위치한 임베딩 공간에서 가장 가까운 약 22만 9,000개의 영어 단어를 직접 매핑해 텍스트로 변환하는 방식을 고안해낸 것입니다.
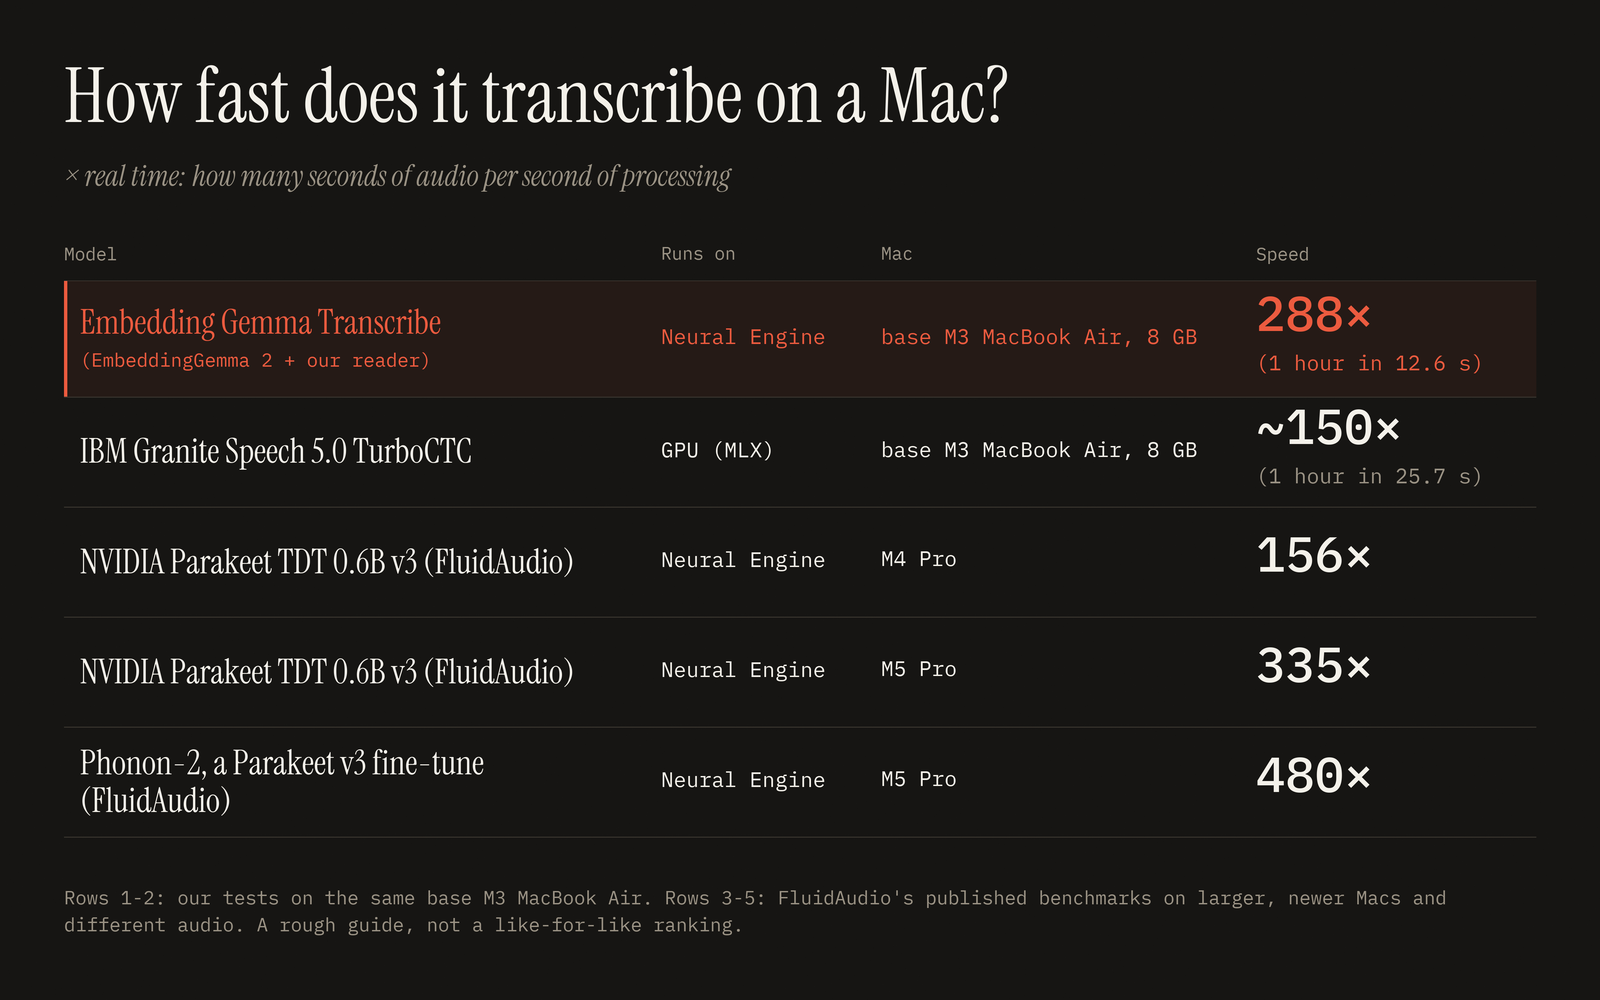
놀라운 점은 모델 본체를 그대로 두고 아주 작은 '리더(reader)' 모듈만 8대의 H100 GPU 환경에서 2시간 미만 동안 학습시켰다는 점입니다. 별도의 소형 모델이 구두점과 대소문자를 보정하며, 기본 M3 맥북 에어(8GB RAM)의 뉴럴 엔진(Neural Engine)에서 1시간 분량의 오디오를 단 12.6초 만에 처리(실시간 대비 약 288배속)하는 속도를 보여주었습니다.
현재 단어 오류율(WER)은 약 5% 수준으로, 선도적인 전문 음성 모델(2~3%)보다는 다소 높지만 추가적인 리더 학습을 통해 격차를 줄일 수 있을 것으로 보고 있습니다. 모든 연산이 기기 내부(온디바이스)에서만 돌아가 외부 유출 우려가 없으며, 오디오 파일 드래그 앤 드롭이나 우측 옵션 키를 누른 채 말하면 어떤 앱에서든 즉시 받아쓰기가 가능한 Mac용 무료 앱으로 배포되었습니다.
Sponsored · 광고