"DB를 큐로 쓰지 말라더니..." 결국 카프카로 회귀한 개발팀 썰
핵심 요약
- 애플 클라우드킷 방식을 참고해 FoundationDB를 메시지 큐로 쓰던 Tigris 팀이 가비지 컬렉션 등 비동기 작업을 카프카로 분리 이전했습니다.
- DB 내 트랜잭션 처리가 가능해 이중 쓰기 문제는 없었으나, 잦은 쓰기·스캔으로 인한 DB 부하와 복잡한 커스텀 코드 유지보수 한계에 부딪혔기 때문입니다.
- 운영 복잡도 때문에 극도로 기피하던 카프카를 결국 도입하며 성능 부하를 낮추고 코드를 대폭 줄였습니다.
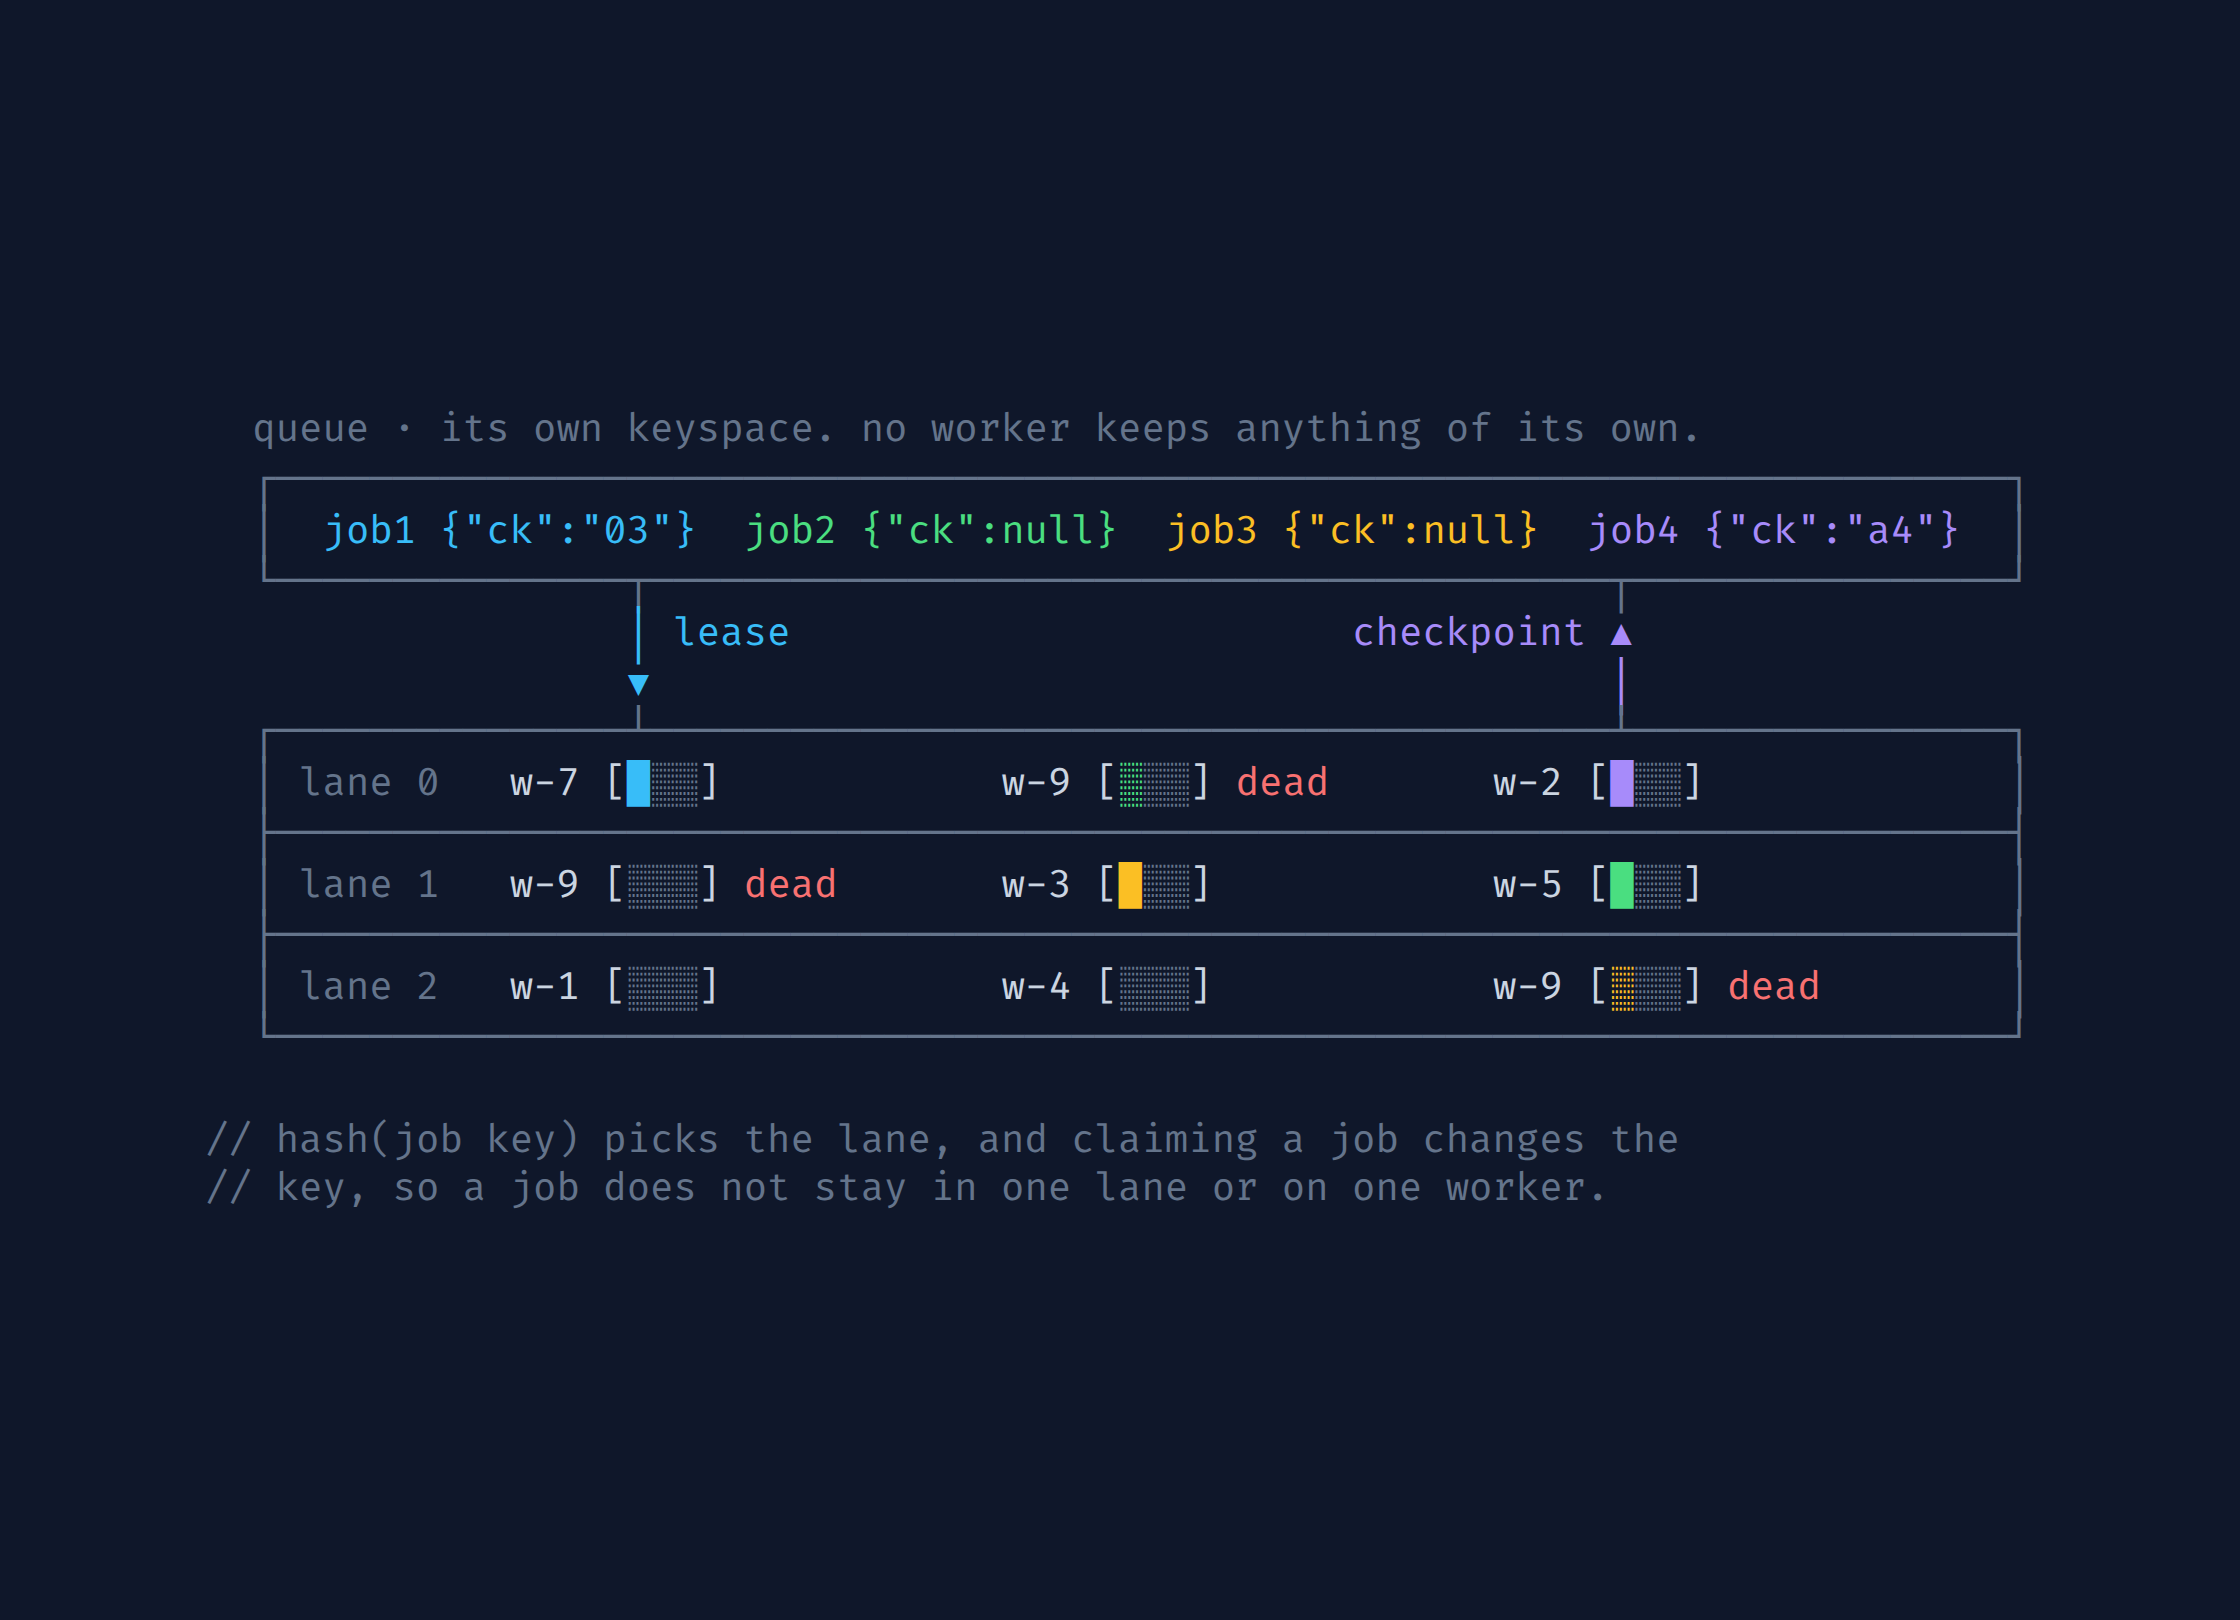
요약 글로벌 객체 스토리지 서비스인 Tigris는 그동안 애플 클라우드킷(CloudKit)의 큐잉 시스템(QuiCK) 논문을 바탕으로 FoundationDB 기반의 메시지 큐를 직접 구현해 사용해 왔습니다. FoundationDB 내부에서 트랜잭션을 처리하면 분산 환경의 골칫거리인 '이중 쓰기(dual-write)' 문제를 피할 수 있고 애플의 대규모 인프라에서도 입증된 방식이었기 때문입니다.
하지만 서비스 기능이 확장되면서 DB를 큐로 쓰는 방식의 한계가 명확해졌습니다. 작업을 스케줄링하고 상태(enqueue, claim, lease 등)를 갱신할 때마다 대량의 쓰기와 스캔이 발생해 실제 유저의 요청을 처리하는 DB 리소스와 심각하게 경쟁하기 시작했습니다. 또한 논문을 바탕으로 자체 개발한 복잡한 커스텀 코드가 많아 신규 엔지니어들이 온보딩할 때 큰 부담이 되었습니다.
결국 가비지 컬렉션(GC) 등 부하가 큰 비동기 작업들을 카프카(Kafka)로 분리 이전하기로 결정했습니다. 과거에는 JVM 플래그 튜닝의 악몽이나 주키퍼(ZooKeeper) 관리 등 운영 난이도(일명 '카프카적 고통') 때문에 카프카를 극도로 기피했으나, DB 부하 분산과 자체 구현 코드 감축을 위해 실용적인 타협을 택했습니다. 기존의 모든 큐를 일괄 대체한 것은 아니며, 핵심 트랜잭션 큐는 유지하면서 무거운 비동기 작업을 선별 이전하는 하이브리드 방식으로 인프라를 최적화했습니다.
Sponsored · 광고