"git clone 놔두고 왜 웹 렌더링을 긁어가냐" AI 봇에 털리는 리눅스 커널 서버 현황
핵심 요약
- AI 모델 훈련을 위해 오염되지 않은 리눅스 커널 커밋 데이터를 노리는 크롤러들이 서버 자원을 심각하게 잠식하고 있습니다.
- 효율적인 'git clone' 대신 수백만 건의 커밋을 일일이 웹 HTML로 요청하는 비효율적인 방식을 고집해 14개 CPU 코어가 봇 렌더링에만 낭비되고 있습니다.
- 가정용 IP 프록시를 쓰고 연산 챌린지 난이도까지 돌파하며 하루 600만 건씩 몰려드는 봇 때문에 서버 관리진이 골머리를 앓고 있습니다.
요약 리눅스 커널 인프라를 총괄하는 콘스탄틴 랴비체프(Konstantin Ryabitsev)가 AI 크롤러 봇들의 무차별적인 스크래핑으로 인해 겪고 있는 막대한 서버 낭비 실태를 폭로했습니다. 리눅스 커널 전체 커밋 역사는 AI가 생성한 오염된 데이터가 전혀 섞이지 않은 순수 훈련 데이터의 '금광'으로 꼽혀 AI 업체들의 주요 타깃이 되고 있습니다.
문제는 봇들이 가장 비효율적인 방식으로 데이터를 긁어간다는 점입니다. 리눅스 커널 저장소는 누구나 통째로 git clone을 받아 로컬에서 커밋을 탐색할 수 있도록 개방되어 있습니다. 하지만 AI 크롤러들은 이 효율적인 방식을 무시한 채, 웹 인터페이스(cgit)에서 148만 개에 달하는 커밋과 922개의 포크(fork) 저장소, 패치, diff 페이지를 일일이 HTML 웹페이지로 렌더링하도록 요청해 파싱하고 있습니다. 이로 인해 수십억 개가 넘는 URL을 끊임없이 호출하면서, 5개 글로벌 노드에 걸쳐 14개의 CPU 코어가 하루 종일 크롤러용 HTML 렌더링에만 묶여 있는 실정입니다. 심지어 정상적인 git clone을 포함한 모든 정당한 트래픽을 합친 것보다 봇용 커밋 렌더링에 소모되는 CPU 연산량이 더 많다고 밝혔습니다.
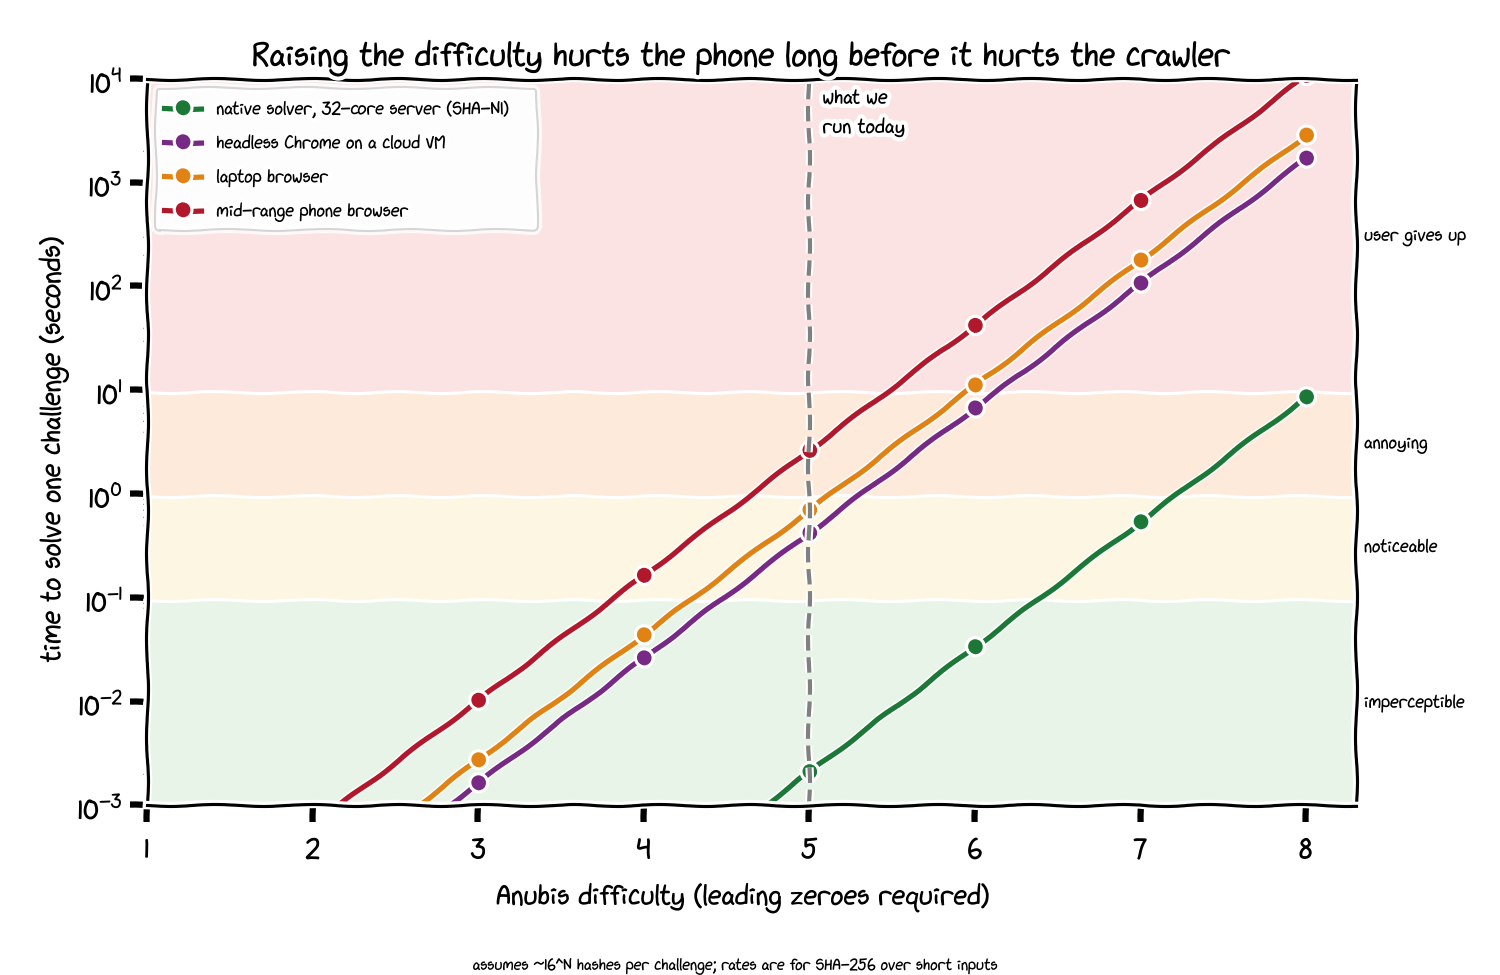
서버 관리 측의 방어 과정도 처절했습니다. 처음에는 User-Agent를 숨기더니, 데이터센터 클라우드 IP 대역을 차단하자 '주거용 프록시 SDK'를 악용해 일반 가정의 스마트 TV나 모바일 기기 IP 수백만 개를 타고 메뚜기 떼처럼 치고 빠지는 수법으로 진화했습니다. 이에 관리팀은 암호화 작업증명(Proof of Work) 솔루션인 아누비스(Anubis)를 도입해 봇에게 난수 연산을 강제했습니다. 난이도 4를 적용하자 봇들이 물러갔지만 몇 달 뒤 연산 능력을 키워 뚫었고, 난이도 5로 높이자 모바일 기기가 뜨거워질 정도로 정상 사용자의 불편이 커졌음에도 결국 봇들이 이마저 연산해 돌파하기 시작했습니다. 현재 git.kernel.org는 매일 600만 건의 커밋 요청을 받고 있으며, 크롤러와의 끝없는 소모전을 이어가고 있습니다.
Sponsored · 광고