우버가 대규모 서버 마비 부르는 '재시도 폭풍' 막아낸 비결
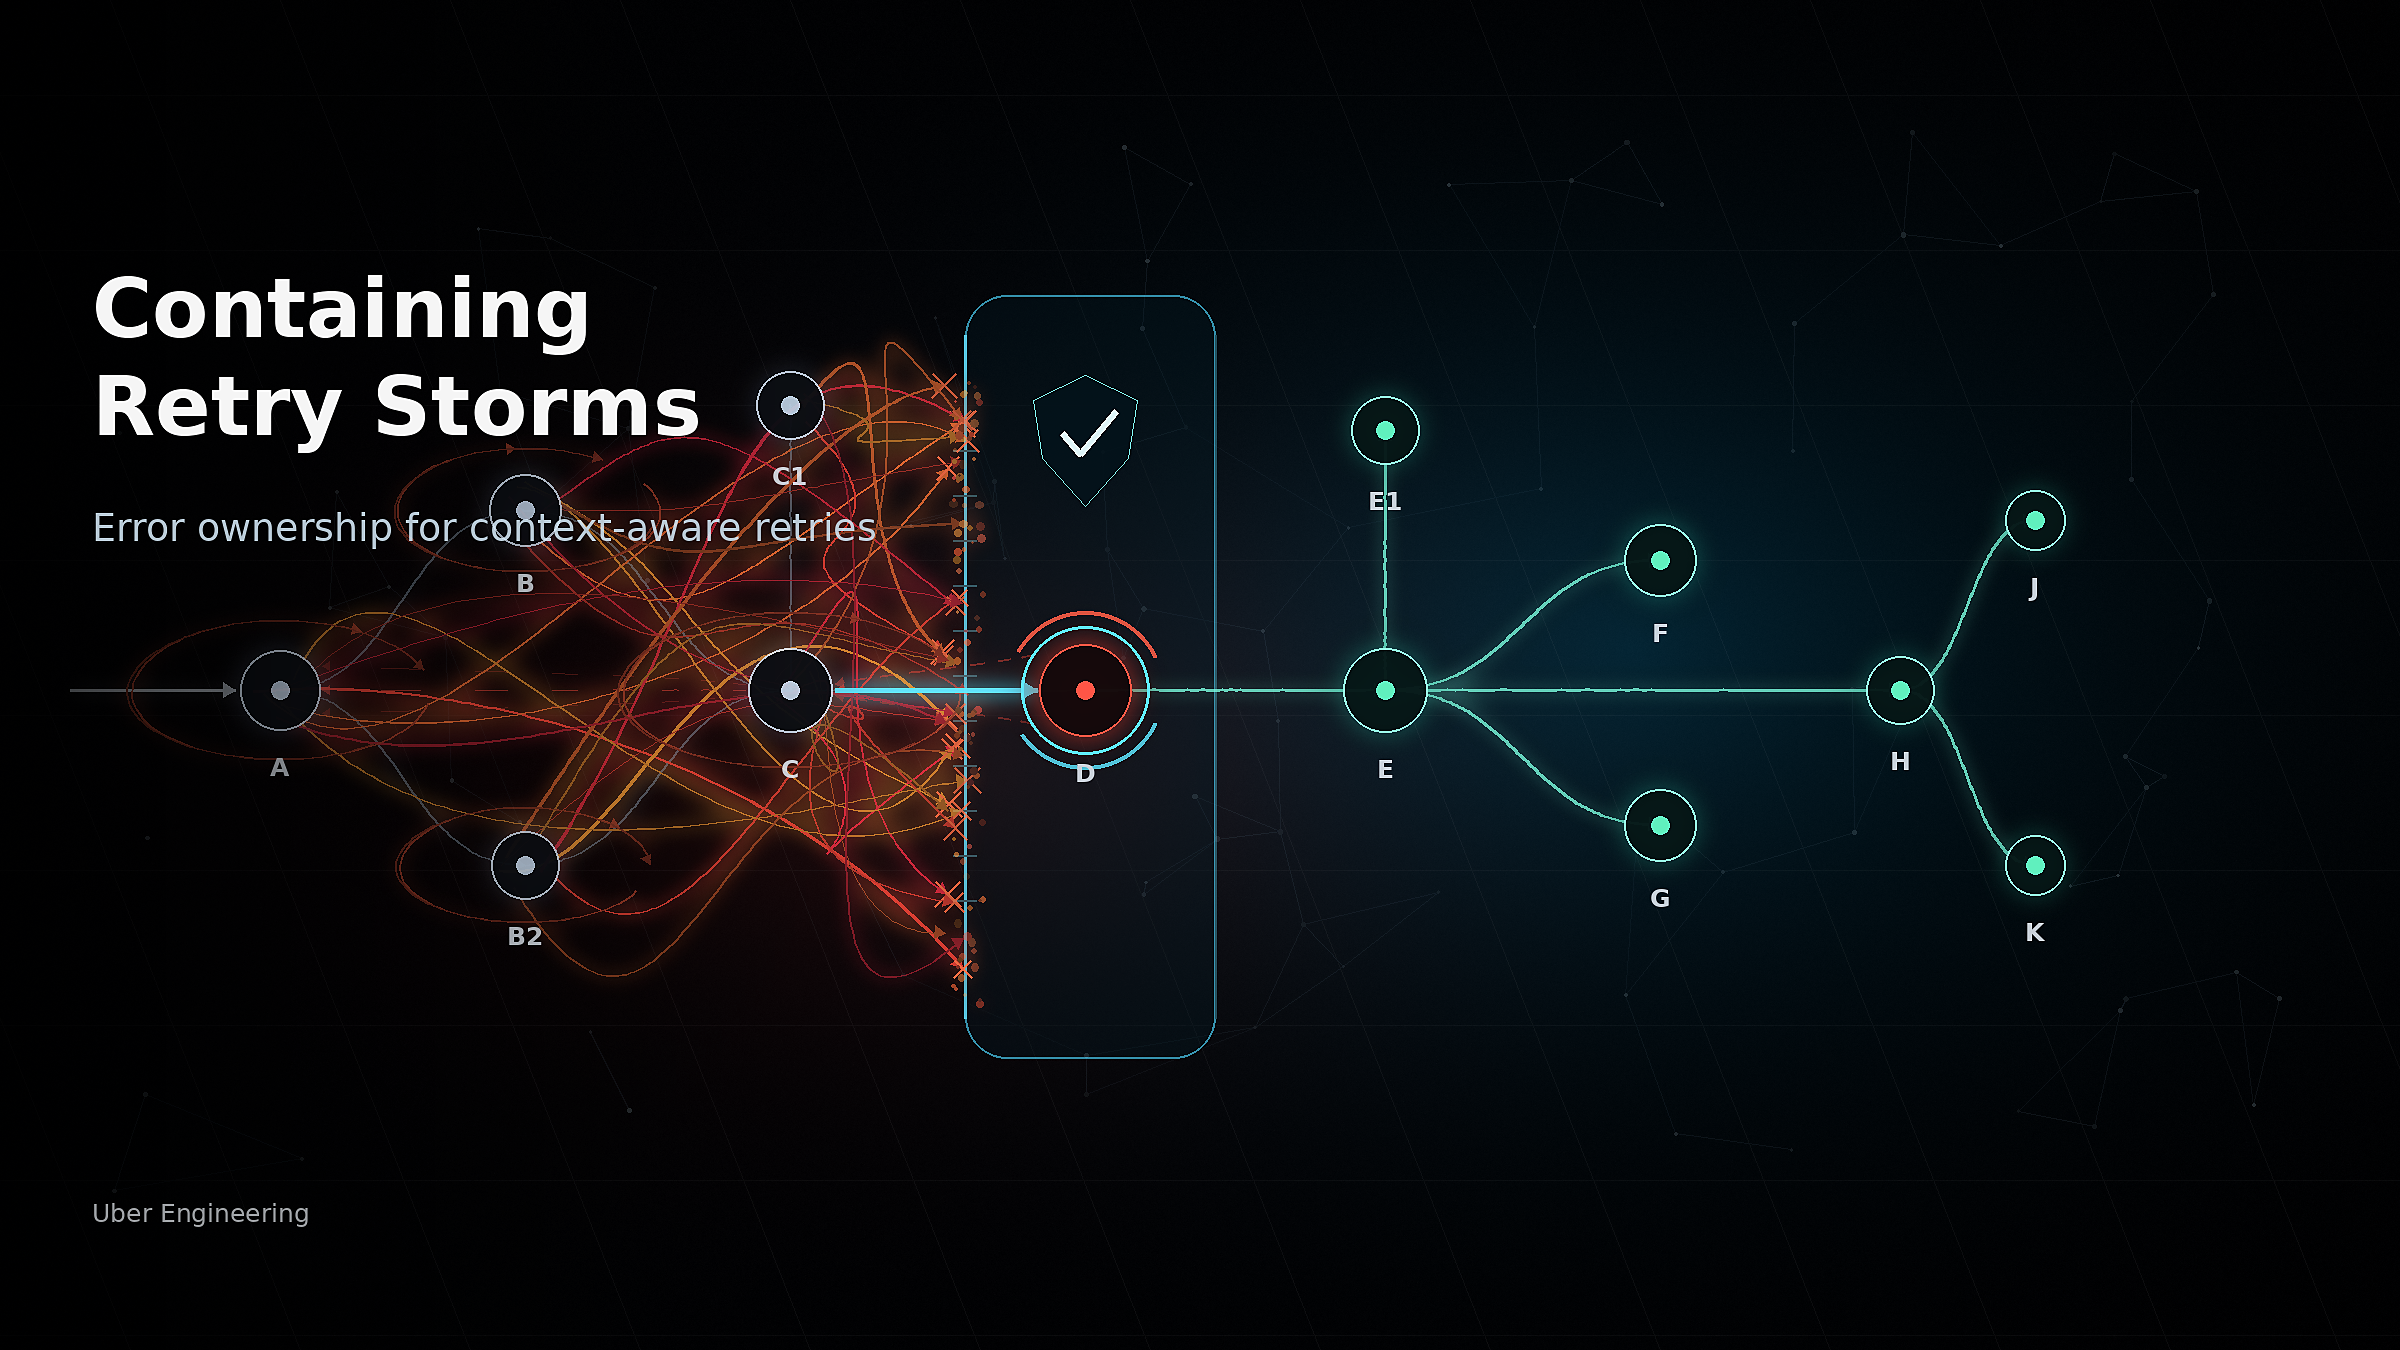
핵심 요약
- 우버가 마이크로서비스의 깊은 의존성 체인에서 발생하는 재시도 트래픽 증폭 현상('재시도 폭풍')의 구조와 위험성을 밝혔습니다.
- 단순한 재시도 횟수나 예산 제한만으로는 계층별 오류 전파를 막지 못해 장애가 인프라 전체로 번지는 한계가 있었습니다.
- 오류를 직접 일으킨 계층을 판별해 상위 호출자의 무차별 재시도를 차단하는 '에러 오너십' 기반의 공유 인프라 메커니즘을 구축해 해결했습니다.
요약 우버(Uber) 엔지니어링 팀이 대규모 분산 시스템에서 연쇄 장애를 유발하는 '재시도 폭풍(Retry Storm)'을 방지하기 위한 아키텍처와 해결책을 공유했습니다. 마이크로서비스 환경에서는 호출 체인이 깊어질수록 하위 서비스의 일시적 장애가 상위 서비스들의 반복적인 재시도로 인해 기하급수적으로 증폭되는 문제가 발생합니다.
예를 들어 단일 서비스가 호출 실패 시 1회씩만 재시도하도록 설정되어 있더라도, 깊이(Depth)가 6단계에 이르면 하위 노드가 처리해야 할 요청 수는 기본 요청의 수 배에서 수십 배(R^d)까지 폭증하게 됩니다. 각 서비스에 10% 수준의 '재시도 예산(Retry Budget)'을 할당하더라도 호출 체인을 타고 올라가며 요청 수가 누적되어 결국 전체 인프라가 마비되는 도미노 현상을 피하기 어렵습니다.
우버는 이러한 재시도 증폭의 근본적인 원인이 '맥락을 인지하지 못하는(context-unaware) 획일적 재시도'에 있다고 분석했습니다. 서비스가 직접 발생시킨 오류와 단순히 하위 서비스로부터 전파받은 오류를 구분하지 못해 모든 계층에서 무차별적으로 재시도를 시도하기 때문입니다. 일시적인 단발성 에러에는 재시도가 효과적이지만, 서비스 과부하나 DB 장애 같은 심각한 문제 상황에서는 재시도가 오히려 장애 복구를 방해하고 시스템을 완전히 무너뜨리는 역효과를 냅니다.
이를 해결하기 위해 우버는 공유 인프라 차원에서 오류의 근원지를 식별하는 '에러 오너십(Error Ownership)' 개념을 도입했습니다. 장애가 처음 발생한 노드와 그 바로 상위 호출자 사이에서만 선별적으로 재시도를 허용하고, 그보다 더 상위 노드들에서는 불필요한 재시도를 원천 차단함으로써 전체 호출 경로의 안정성을 유지하면서도 하위 노드에 가해지는 과도한 부하를 효과적으로 억제하는 구조를 구축했습니다.
Sponsored · 광고