메타가 작정하고 짓는 중인 GPU 100만 개짜리 역대급 AI 데이터센터 근황
핵심 요약
- 메타가 오하이오주에 최대 100만 대의 GPU를 하나로 묶는 기가와트급 차세대 AI 슈퍼클러스터 '프로메테우스' 1단계를 구축하고 내부 스펙을 공개했습니다.
- 엔비디아 블랙웰 기반 GB200 및 GB300 NVL72 플랫폼과 수랭식 랙 구조를 적용해 단일 랙에서 엑사플롭급 연산력을 구현했습니다.
- 이미 메타의 차세대 프론티어 AI인 '뮤즈(Muse)' 학습에 성공적으로 투입되었으며, 향후 엔비디아의 차차세대 베라 루빈까지 순차 도입할 계획입니다.
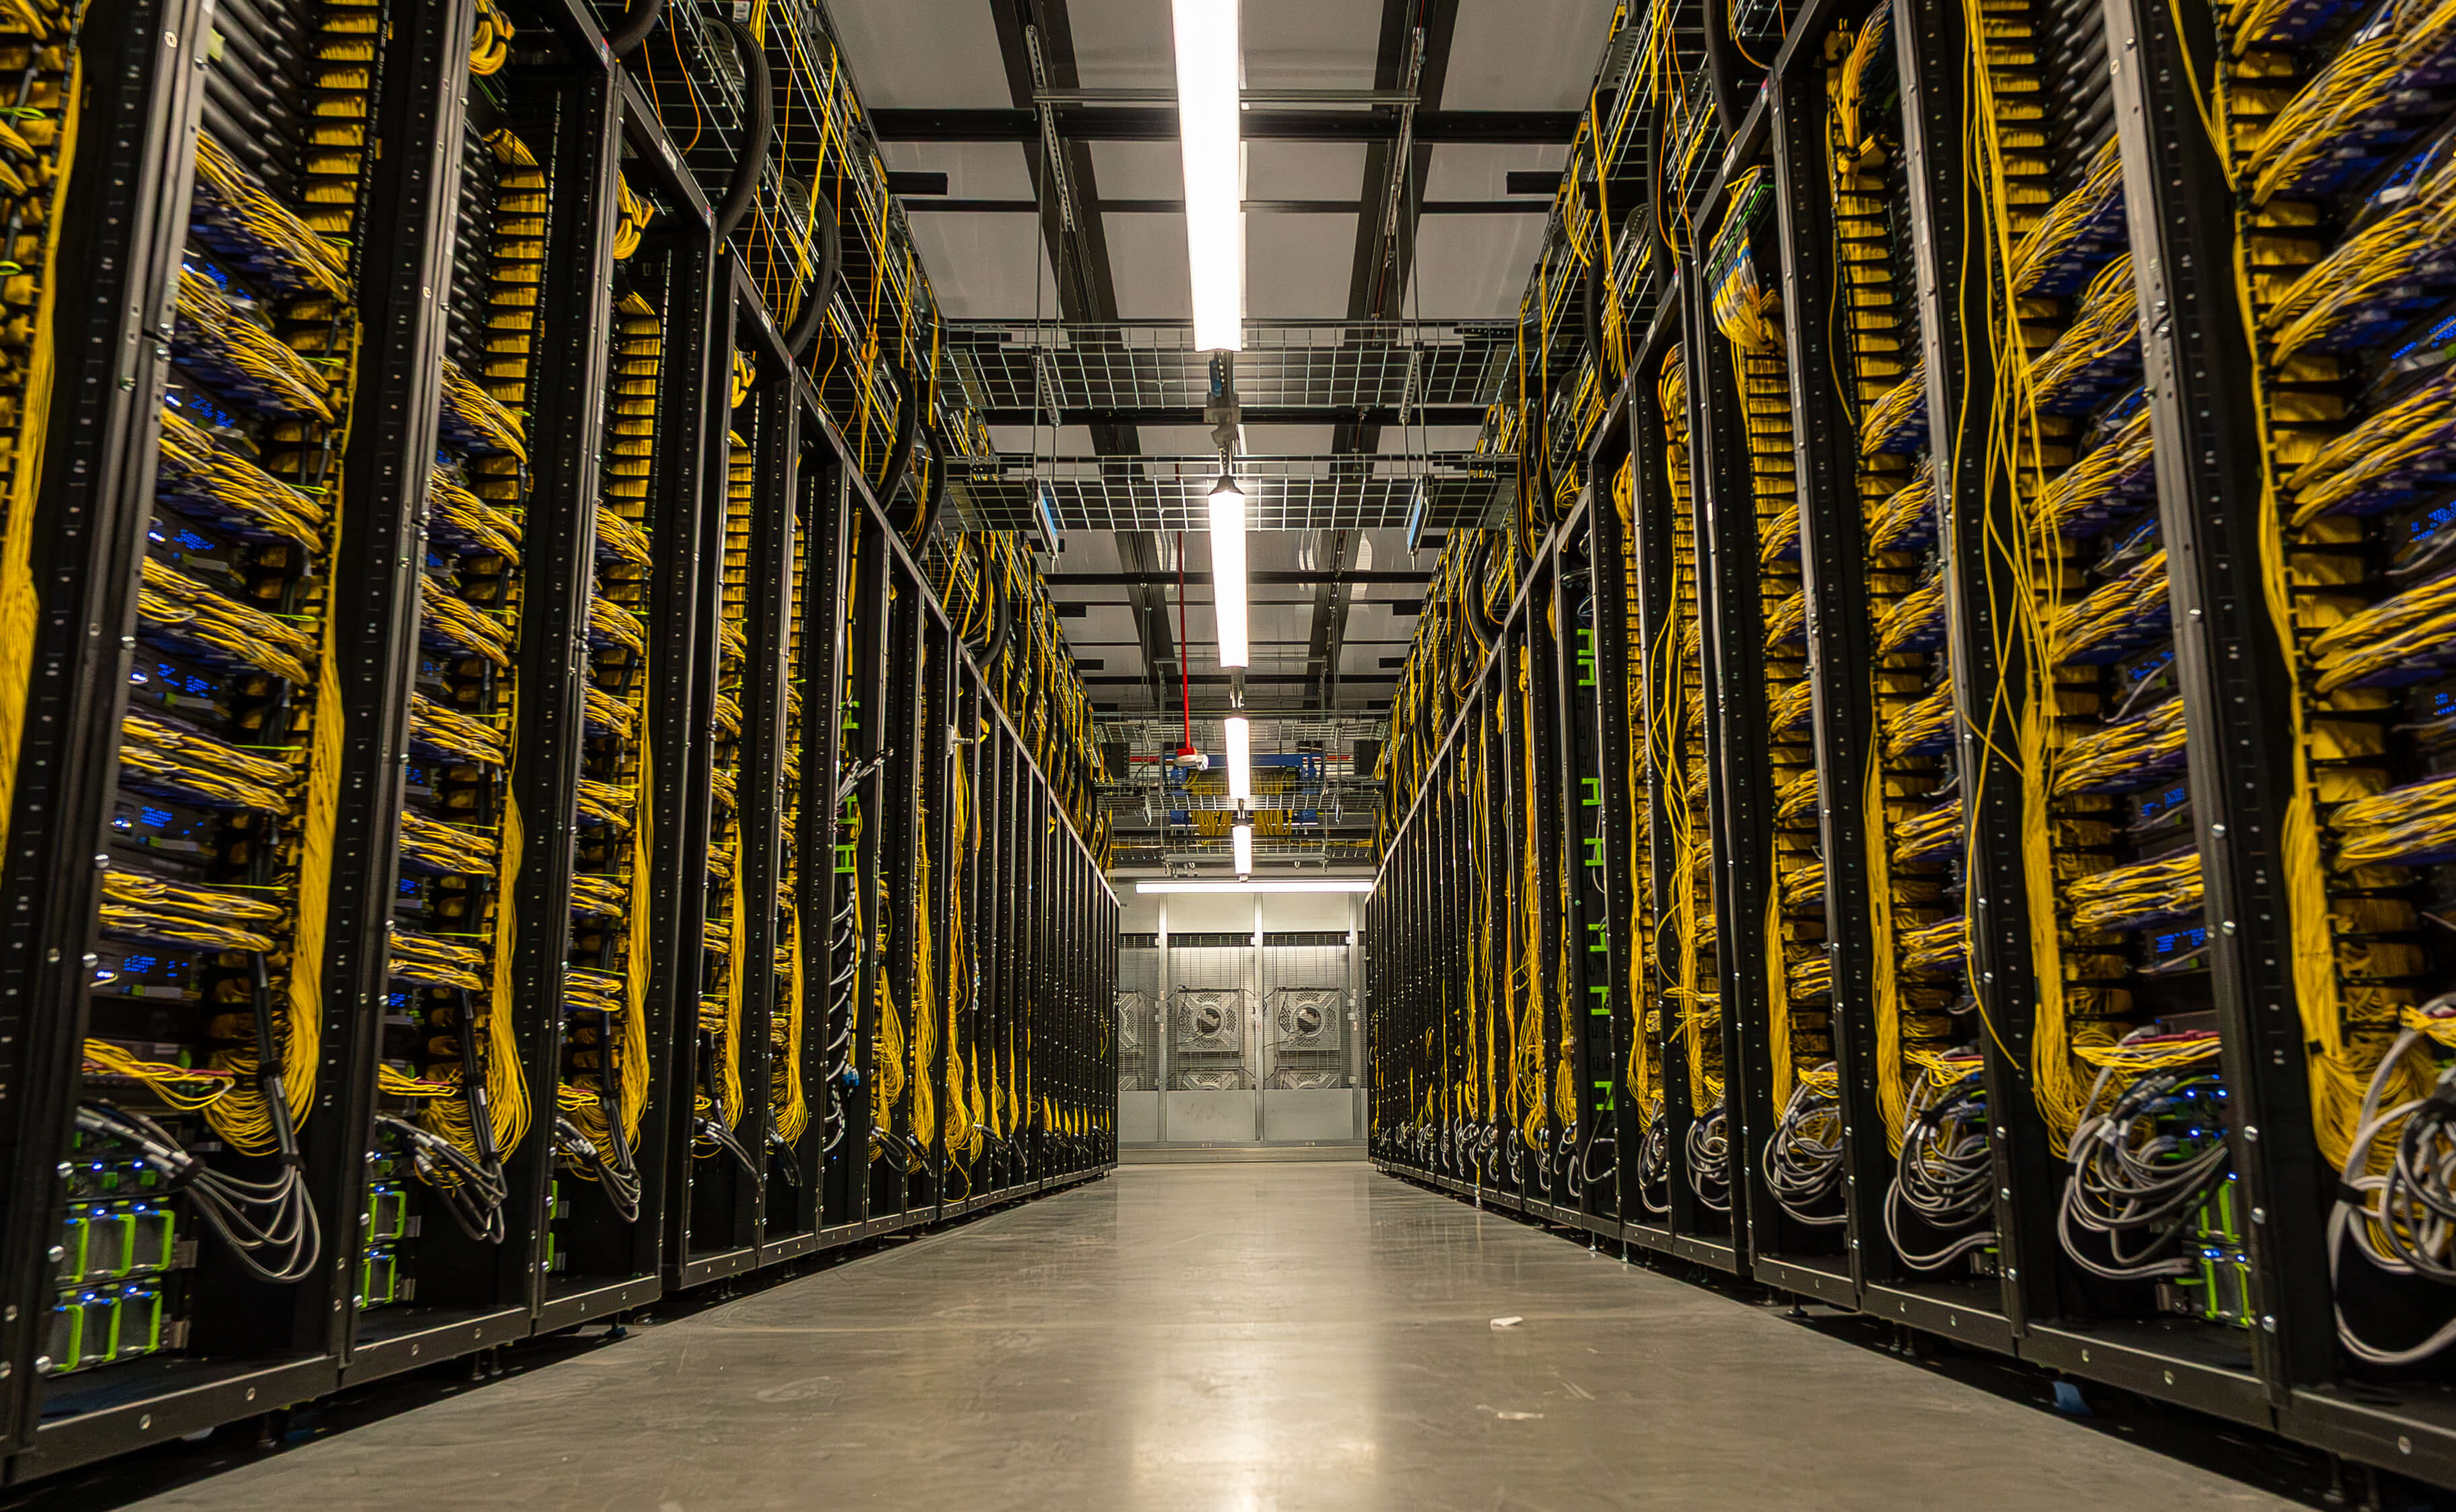
요약 메타(Meta)가 미국 오하이오주 뉴올버니 데이터센터에 구축 중인 기가와트(GW) 규모의 차세대 AI 슈퍼클러스터 '프로메테우스(Prometheus)'의 인프라 세부 사양을 공개했습니다.
2년 전만 해도 일반 웹 트래픽을 처리하던 이 데이터센터는 현재 수십만 대의 GPU가 광섬유로 촘촘히 엮여 거대한 단일 머신처럼 동작하는 공간으로 탈바꿈했습니다. 메타의 목표는 향후 이 클러스터를 무려 100만 대 규모의 GPU 분산 네트워크로 확장하는 것입니다. 이미 구축 완료된 1단계 시스템은 최근 메타의 차세대 에이전트 기반 프론티어 AI 모델인 '뮤즈(Muse)' 제품군(Muse Wonder 포함) 사전 학습 및 강화학습(RL)에 투입되었으며, 각각 85%와 90% 이상의 유효 작업 처리율(goodput)을 기록했습니다. 또한 시스템 중단 간격(MTBI)을 5만 4천 GPU 시간 이상으로 끌어올리며 대규모 학습 시의 안정성을 입증했습니다.
프로메테우스에는 엔비디아의 차세대 GPU 플랫폼들이 단계적으로 도입되고 있습니다. 첫 번째 플랫폼인 '카탈리나(Catalina)'는 엔비디아 GB200 NVL72 기반으로, 2개 랙에 걸쳐 72개의 블랙웰(Blackwell) GPU와 13.4TB의 HBM3e 메모리를 탑재해 최대 720 PFLOPS(FP8 기준) 연산력을 냅니다. 특히 스케일아웃 병목을 방지하기 위해 GPU당 800G I/O를 업계 선도적으로 적용한 아리엘(Ariel) 구성을 채택했습니다.
두 번째 플랫폼인 '클레멘테(Clemente)'는 엔비디아 GB300 NVL72(블랙웰 울트라)로 업그레이드되어 GPU당 HBM 용량이 288GB로 50% 늘어났고, 단일 랙에서 1 엑사플롭(ExaFLOP, FP4 기준) 이상의 연산 성능을 발휘합니다. 냉각 방식 역시 폐쇄형 액체 냉각(Closed-loop liquid cooling) 및 공기 보조 액체 냉각(AALC), 시설 액체 냉각(FLC) 등을 전면 도입했습니다. 메타는 조만간 엔비디아의 차차세대 플랫폼인 베라 루빈(Vera Rubin NVL72)까지 순차 배치하여 초지능 연구소(Meta Superintelligence Labs)의 차세대 모델 개발을 가속화할 계획입니다.
Sponsored · 광고