사람이 안 가르쳤더니 온갖 꼼수(?) 스스로 터득해서 부품 조립하는 로봇 등장
핵심 요약
- 알파제로의 학습 철학을 도입해 시뮬레이션 환경에서 초정밀 부품 조립을 스스로 학습하는 로봇 AI '알파NIST'가 공개되었습니다.
- 세부 조작법 없이 오직 조립 성공 여부만 보상으로 주자, 20개 부품을 한꺼번에 배운 단일 정책이 각 부품별 전문 정책보다 더 뛰어난 성공률을 보였습니다.
- 로봇은 부품을 바닥에 비벼 돌리거나 손가락 끝으로 톡톡 쳐서 너트를 조이는 등 인간이 가르쳐주지 않은 독창적인 조작 요령을 스스로 터득했습니다.
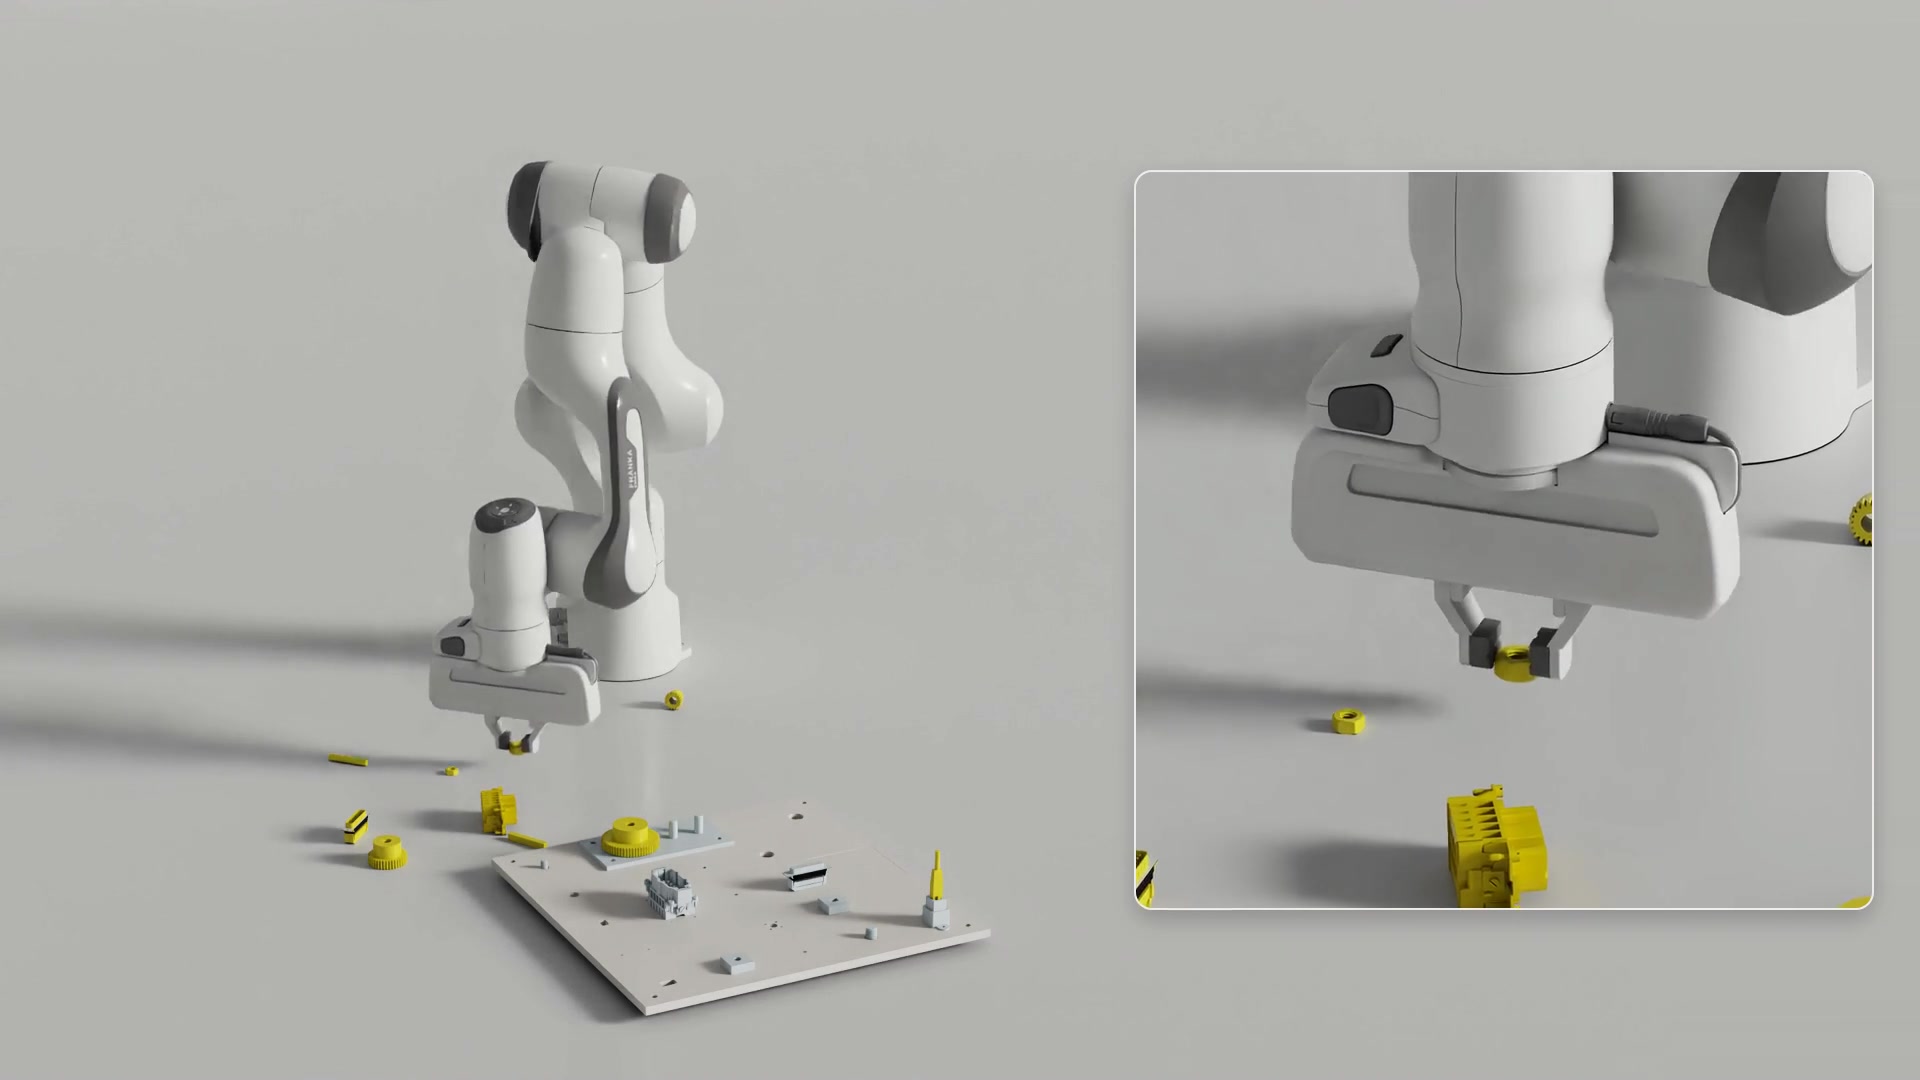
요약 알파고와 알파제로가 방대한 경험 학습을 통해 기존 인간 기사들이 생각지 못한 새로운 수법을 스스로 터득했던 것처럼, 로봇 조립 분야에서도 똑같은 철학을 적용한 '알파NIST(AlphaNIST)' 연구가 공개되었습니다. 이번 프로젝트는 미국 국립표준기술원(NIST)의 정밀 조립 태스크 보드(NIST Assembly Task Board #1)를 시뮬레이션 상에서 해결하는 강화학습 정책을 다룹니다.
NIST 조립 보드는 직경 4mm 수준의 아주 작은 부품부터 볼트, 너트, 기어, 펙, 커넥터 등 20가지에 달하는 다양한 부품들을 다루어야 하며, 부품 간의 유격이 극히 좁아 볼트 각도가 조금만 틀어져도 나사산이 엉키거나 부품이 걸려버리는 고난도 작업입니다. 게다가 여러 부품을 조립할 때는 특정 부품이 다음 조립 경로를 막을 수 있어 조립 순서까지 전략적으로 판단해야 합니다.
연구진은 로봇에게 사람이 생각하는 조작 단계나 위치 정렬 보상을 일일이 지정해주는 대신, 오직 성공 여부만을 따지는 '이진 보상(Binary task reward)'만을 부여하고 방대한 환경에서 스스로 해법을 찾게 했습니다. 흥미롭게도 도달(reaching)이나 정렬(alignment) 같은 세부 보상을 추가했을 때는 오히려 성공률이 떨어졌으며, 20가지 작업을 별도로 학습한 전문 정책들보다 20가지 작업을 한꺼번에 학습한 단일 엔드투엔드 정책이 훨씬 더 높은 훈련 성공률을 기록했습니다.
학습 결과 로봇은 사람의 손동작을 흉내 내는 대신 두 손가락 그리퍼의 특성을 살린 독창적인 조립 기술들을 스스로 발현시켰습니다. 예를 들어 부품을 길게 꽂기 위해 바닥에 내려놓았다가 끝부분을 다시 고쳐 잡거나, 방수 커넥터를 보드 모서리에 비벼서 회전시킨 뒤 삽입하고, 손가락 끝으로 톡톡 쳐가며 나사를 조이는 등 사람이 직접 가르쳐주지 않은 기발한 물리적 요령들을 스스로 터득해 조립을 완수해냈습니다.
Sponsored · 광고