로봇 AI가 똑똑해지기 힘든 이유: 데이터 모으려고 사람이 수동 조작 노가다 중?
핵심 요약
- 인터넷 텍스트를 긁어모아 발전한 LLM과 달리, 로봇 AI는 학습에 필요한 대규모 공개 데이터가 턱없이 부족합니다.
- 현재는 사람이 직접 로봇을 원격 조작하며 동작 데이터를 수집하고 있으나, 비용이 크고 정교한 촉각 피드백 수집이 어렵다는 한계가 있습니다.
- 원격 조작 데이터 중 일부만 쓸모가 있어, 로봇 스스로 학습하는 강화 학습 등 데이터 수집 방식을 둘러싼 난제가 이어지고 있습니다.
요약 최근 AI 기술의 비약적인 발전은 엄청난 양의 학습 데이터 덕분에 가능했습니다. GPT-3 같은 거대 언어 모델(LLM)은 인터넷 전체에서 긁어모은 수천억, 수조 개의 텍스트 토큰을 먹어치우며 똑똑해졌고, 2024년 기준 인터넷상에서 활용 가능한 양질의 텍스트 데이터만 약 300조 토큰에 달하는 것으로 추정됩니다.
하지만 이 AI 모델을 현실의 로봇에 적용하려 하자 가장 근본적인 문제에 부딪혔습니다. 바로 로봇을 학습시킬 양질의 데이터가 텍스트처럼 인터넷에 널려 있지 않다는 점입니다.
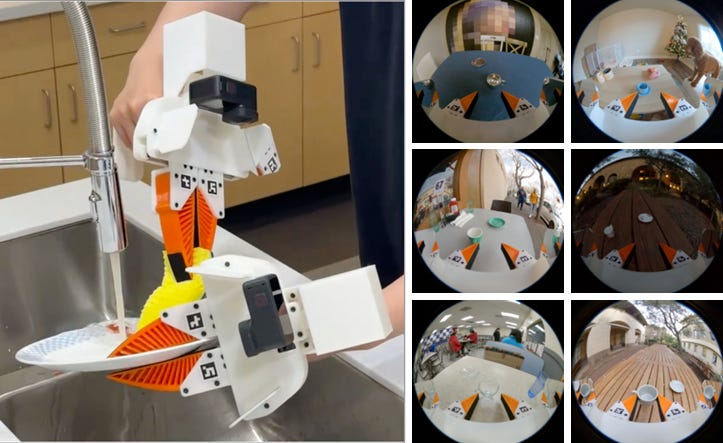
로봇을 학습시키기 위해서는 특정 작업(옷 개기, 컵에 물 따르기 등)을 올바르게 수행한 수많은 기록이 필요합니다. 이를 위해 역사적으로 가장 널리 쓰여온 방식이 바로 '원격 조작(Teleoperation)'입니다. 사람이 컨트롤러를 잡고 로봇을 직접 원격 조작해 작업을 수행하면, 로봇 팔의 관절 각도 변화 같은 기계 상태와 로봇에 달린 카메라 영상을 함께 기록해 학습 데이터로 만듭니다. 이렇게 전문가(인간)의 행동을 따라 하게 만드는 방식을 '행동 복제(Behavioral Cloning)'라고 부릅니다.
실제로 로봇 훈련 데이터를 모으기 위해 사람들이 온종일 로봇 원격 조작만 반복하는 거대한 '데이터 수집 공장'까지 생겨났습니다. 하지만 이 방식은 치명적인 한계가 있습니다. 첫째는 비용입니다. 실제 로봇 기체와 이를 조작할 사람이 상시 투입되어야 해 데이터 규모를 무한정 늘리기 어렵습니다. 둘째는 조작의 둔탁함입니다. 조작자가 직접 물건의 촉감을 느끼기 어려워 정교하고 섬세한 손놀림 데이터를 얻기 힘들고, 사람이 로봇의 가동 범위를 깜빡해 무리하게 움직이다가 사고가 나기도 합니다. 결국 이렇게 수집된 데이터 중 실제로 쓸모 있는 비율은 일부에 불과하다는 설명입니다.
이에 대안으로 로봇이 스스로 움직이며 성공과 실패를 판정해 데이터를 쌓는 '강화 학습(Reinforcement Learning)' 등 다양한 방식이 모색되고 있지만, 로봇을 길들이기 위한 데이터 확보 경쟁은 여전히 AI 로봇 분야의 최대 난제로 꼽히고 있습니다.
Sponsored · 광고