토크나이저 없애고 연산 효율 10배 끌어올렸다는 신개념 AI 모델 H-Net 연구 공개
핵심 요약
- 카르테시아가 사전 토크나이저 없이 바이트 단위에서 직접 언어 패턴을 학습하는 계층형 네트워크 'H-Net'을 발표했습니다.
- 인지심리학의 청킹 개념을 적용해 데이터와 연산량을 기존 대비 최대 10배 절감하면서도 더 뛰어난 성능을 보였습니다.
- 텍스트 언어 모델뿐 아니라 생물학, 비전 등 다양한 모달리티로 확장 가능한 범용 학습 구조로 평가받고 있습니다.
요약 기존 거대언어모델(LLM)들은 텍스트를 직접 읽는 대신 사람이 사전에 정의한 토크나이저(BPE 등)를 거쳐 고정된 어휘 토큰 단위로 변환해 처리해 왔습니다. 하지만 AI 스타트업 카르테시아(Cartesia)는 이러한 사전 가공 방식이 데이터로부터 완전히 엔드투엔드(end-to-end)로 학습하는 것을 가로막는 병목이라고 지적했습니다.
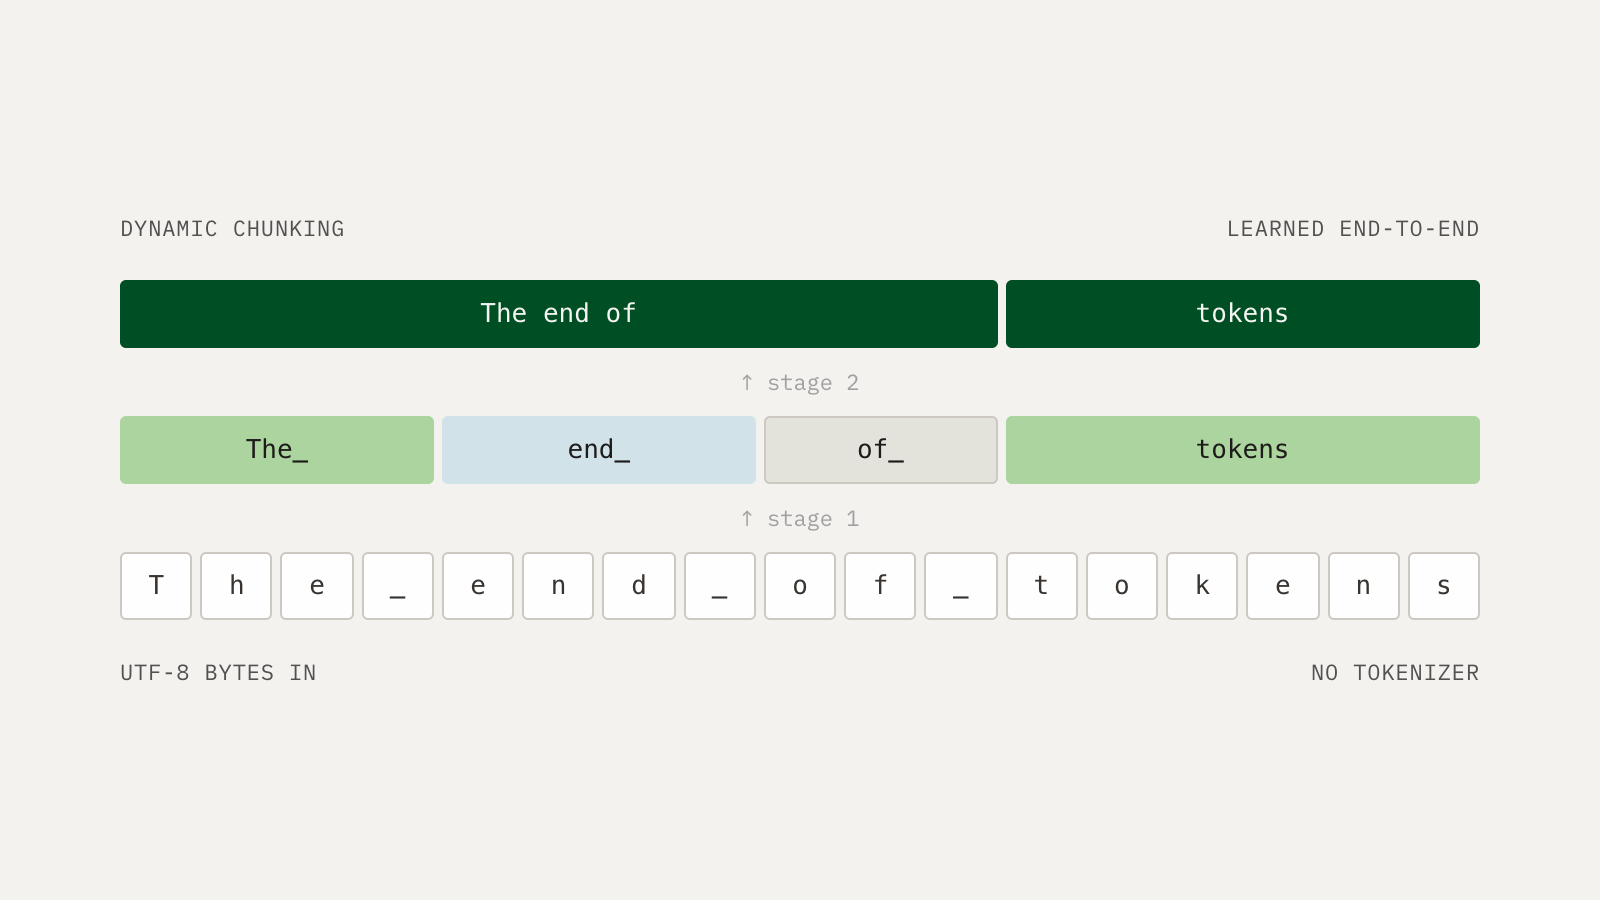
카르테시아 연구진은 인지심리학의 '청킹(chunking)' 개념에서 착안해, 사전 제작된 토크나이저를 없애고 로우 데이터(바이트 수준)에서 상위 개념을 스스로 동적으로 묶어내는 계층형 네트워크(Hierarchical Networks, H-Nets) 기술을 공개했습니다. 문자를 단어로, 단어를 구문으로, 구문을 개념으로 모델 내부에서 직접 계층화해 학습하는 구조입니다.
실험 결과에 따르면, 1단계 H-Net만으로도 순수하게 학습된 토큰화 과정을 통해 연산 효율을 3~5배 향상시켰으며, 더 유연한 2단계 H-Net의 경우 기존 오픈소스 모델 대비 연산량과 데이터를 10분의 1만 사용하고도 더 우수한 성능을 기록했다고 밝혔습니다. 연구진은 또한 H-Net이 컨텍스트 내 토큰화 등 기존 LLM에서 볼 수 없던 새로운 패턴을 학습하고 있으며, 텍스트뿐만 아니라 생물학 데이터나 비전 분야 등 다양한 모달리티로 확장 가능한 범용 아키텍처로서의 가능성을 보여주고 있다고 설명했습니다.
Sponsored · 광고