가성비 AI로 한 달 코딩 버티려다 '바이브 코딩'으로 하룻밤에 4억 토큰 날린 썰
핵심 요약
- 오픈소스 CMS Wagtail 팀이 9월 한 달간 저비용 오픈 가중치 모델(GLM 5.3 Flash)만 사용하는 코딩 챌린지에 도전했다.
- 전반기에는 예산 내로 순항했으나, 바이브 코딩으로 프로토타입을 제작하다 하룻밤 새 4억 5천만 토큰(약 150달러)을 날리는 등 돌발 상황이 발생했다.
- 결국 인프라 이슈와 R&D 수요가 겹치며 목표 모델 사용률 50%로 챌린지는 실패했으나, 에이전트 설계와 실시간 비용 측정의 중요성을 배웠다고 전했다.
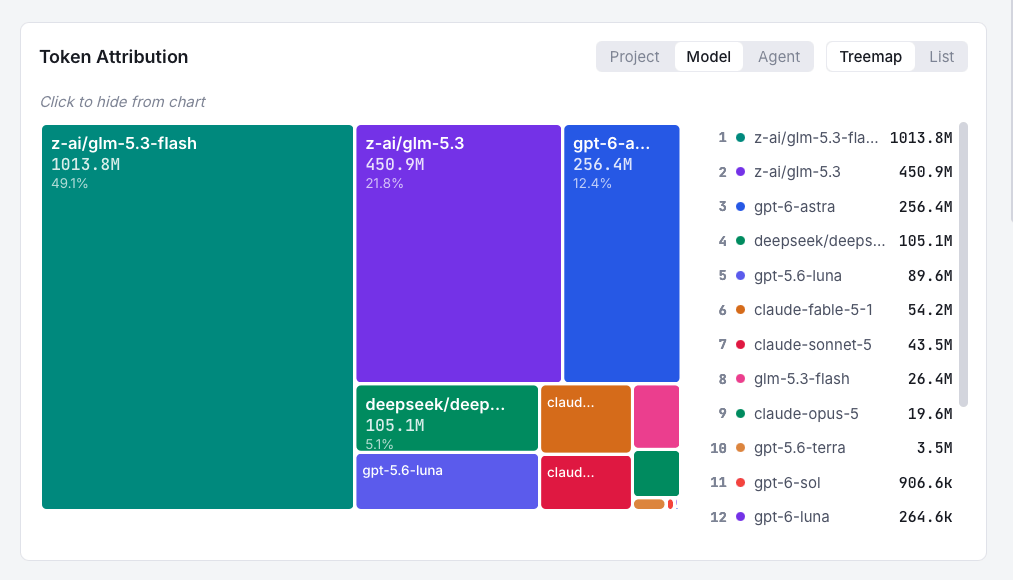
요약 오픈소스 CMS 프로젝트인 Wagtail 개발팀이 9월 한 달 동안 상용 구독 모델 대신 단 하나의 가성비 오픈 가중치 모델(GLM 5.3 Flash)만 사용해 코딩하겠다는 야심 찬 챌린지에 도전했다가 겪은 실패 후기를 공유했습니다. 총 20억 토큰을 소진한 끝에 나온 결론은 '현실은 생각만큼 쉽지 않았다'는 것이었습니다.
9월 전반기는 순조로웠습니다. 목표 모델 하나만으로 일상적인 작업을 잘 처리했고, 비용도 68달러(전력 사용량 약 4kWh, 탄소 배출 365g) 수준으로 예산 범위 내에서 안정적으로 통제되었습니다. 하지만 후반기 들어 예상치 못한 암초를 만났습니다.
가장 큰 문제는 일명 '바이브 코딩(vibe coding)'의 후폭풍이었습니다. 개발팀이 실험용 Wagtail MCP 서버 프로토타입을 빠르게 만드는 과정에서 모델 선택을 잘못하는 바람에, 거의 하룻밤 사이에 4억 5,000만 토큰(약 150달러, 전력 5kWh)이 순식간에 날아갔습니다. 프로토타입 자체는 성공적으로 작동해 데모를 확보했지만, 모델 선택과 에이전트 패턴에 조금만 더 주의를 기울였다면 5분의 1 비용으로 끝낼 수 있었던 작업이었습니다.
여기에 인프라 공급 문제도 발목을 잡았습니다. 대형 연구소들처럼 자체 GPU를 대량 보유하지 못한 추론 제공업체들의 서버가 몰리면서 GLM 5.3 Flash의 성능 저하가 발생했고, 결국 DeepSeek V4.1 Flash나 Qwen 3.8 Flash 같은 대체 모델로 급히 전환해야 했습니다. 게다가 자체 벤치마크 테스트와 다양한 모델 실험 R&D 수요까지 겹치면서 다른 모델 사용량이 급증했습니다.
결국 전체 20억 토큰 중 목표 모델 사용량은 10억 토큰(50%)에 그쳤고, 에너지 소비도 예상했던 10kWh가 아닌 약 35kWh가 나오면서 기술적으로 이번 챌린지는 실패로 끝났습니다. 그러나 개발팀은 무의미한 토큰 수보다는 실제 비용과 에너지 소모를 실시간 추적하고, 오케스트레이터·스카우트·구현·리뷰어로 이어지는 멀티 에이전트 기법을 도입해야 한다는 귀중한 교훈을 얻었다고 전했습니다. 일상적인 개발 작업에는 여전히 플래시급 저비용 모델을 집중적으로 활용하는 전략이 충분히 유효하다고 덧붙였습니다.
Sponsored · 광고