UTF-8 한계 풀고 무한 확장한다는 'UTF-8000' 규격 등장
핵심 요약
- 기존 UTF-8의 길이 제한을 넘어 임의의 큰 정수 코드포인트를 인코딩할 수 있는 확장 규격 'UTF-8000'이 제안되었습니다.
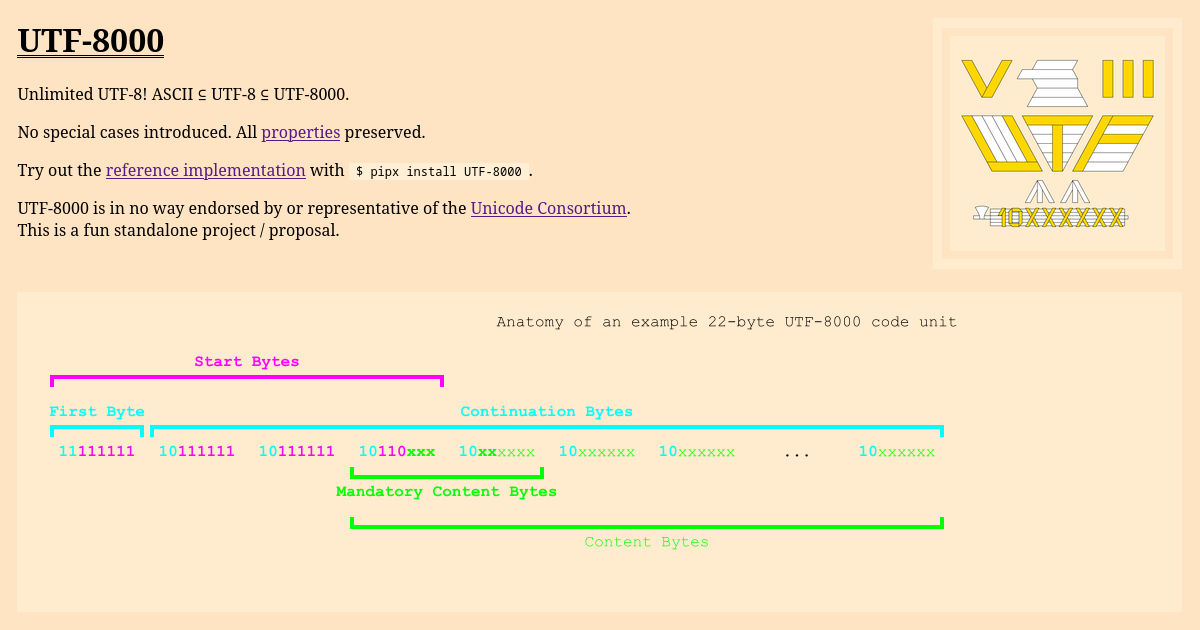
- 첫 바이트의 상위 비트를 분리하고 연속 바이트에 걸쳐 시작 비트를 배치하는 방식으로 22바이트 이상의 무한 확장을 지원합니다.
- 무작위 탐색과 에러 복구에 핵심적인 UTF-8 특유의 바이트 단위 자기 동기화(Self-Synchronization) 속성은 그대로 계승했습니다.
요약 기존 UTF-8 인코딩의 바이트 수 제한을 넘어 이론상 무한한 크기의 코드포인트를 표현할 수 있도록 설계된 확장 규격 'UTF-8000' 제안이 개발자 커뮤니티에서 눈길을 끌고 있습니다.
기존 UTF-8은 첫 바이트의 상위 비트로 전체 길이를 나타내기 때문에 최대 표현 가능한 바이트 수에 명확한 한계가 존재했습니다. 반면 UTF-8000은 첫 바이트에만 존재하던 '시작 비트(start bits)'를 이어지는 연속 바이트(continuation byte)들로 확장 분산 배치할 수 있도록 설계되었습니다. 이를 통해 단일 코드포인트를 인코딩하는 데 22바이트 이상의 임의의 길이(arbitrary code unit lengths)를 가질 수 있는 다중 시작 바이트(multiple start bytes) 구조를 지원합니다.
동시에 UTF-8이 지닌 가장 강력한 특성 중 하나인 '자기 동기화(self-synchronization)' 속성은 그대로 유지됩니다. 파일 내 임의의 위치로 무작위 탐색(random seek)을 하더라도 상위 비트의 프리픽스(0은 아스키, 10은 연속 바이트, 11은 다중 바이트의 첫 바이트)만 확인하면 현재 위치가 코드 단위의 시작점인지 중간 연속 바이트인지를 즉시 판별할 수 있어 손상 복구와 스트림 처리에 유리합니다. 기존 UTF-8의 하위 호환 및 특성을 유지하면서도 무한한 바이트 확장을 꾀한 괴짜 같은 공학적 시도로 평가받고 있습니다.
Sponsored · 광고